
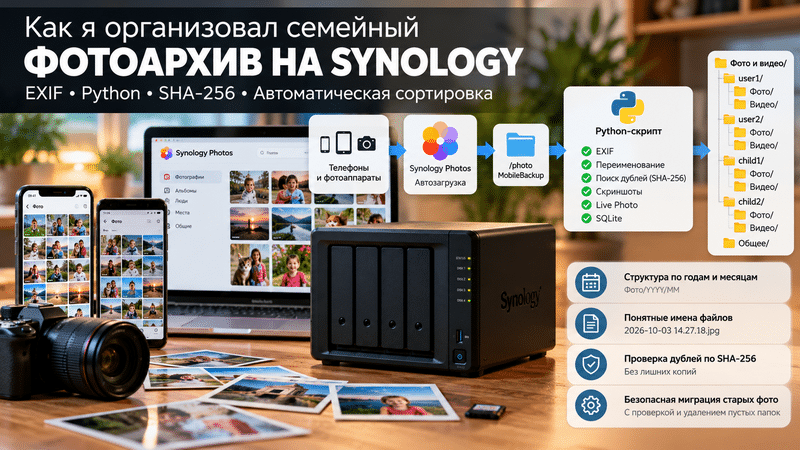
Фотографии имеют неприятное свойство: пока их несколько тысяч, кажется, что никакой системы хранения вообще не требуется.
Есть папка Фото, внутри лежат годы, рядом папка «Отпуск», где-то «Новый год», ещё где-то фотографии с телефона. Что-то хранится на компьютере, что-то на NAS, что-то когда-то было скопировано со старого жёсткого диска.
Но проходят годы.
Меняются телефоны и фотоаппараты. Появляются фотографии детей, поездок, семейных мероприятий. Одни и те же файлы несколько раз перекладываются между дисками.
В какой-то момент появляются каталоги вроде:
Фото
Фотографии
Старые фотографии
Фото старые
Общее
Разобрать
Телефон
Camera
DCIM
Отпуск
Школа
Новый год
А внутри — десятки тысяч файлов:
IMG_0031.jpg
DSC_1842.JPG
PICT0045.JPG
000123.jpg
PXL_20260923_172611.jpg
Примерно к такому состоянию за много лет пришёл и мой семейный фотоархив.
В итоге я решил не просто навести порядок в папках, а построить систему, которая будет работать дальше практически сама.
Основой стал мой Synology NAS, Synology Photos и несколько Python-скриптов.
Главное требование я сформулировал так:
Сам файловый архив должен оставаться понятным и пригодным для использования даже без Synology Photos или любой другой программы-каталогизатора.
То есть если завтра я заменю Synology Photos на Immich или вообще открою NAS обычным файловым менеджером — вся логика хранения останется на месте.
Почему я не стал полагаться только на Synology Photos
Synology Photos мне нравится прежде всего как средство автоматической загрузки фотографий с телефонов.
Смартфоны членов семьи отправляют фотографии на NAS примерно в такие каталоги:
/photo/MobileBackup/user1/Pixel/DCIM/Camera
/photo/MobileBackup/user2/iPhone
/photo/MobileBackup/user3/POCO/DCIM/Camera
Но эти каталоги я решил считать исходным слоем, а не окончательным архивом.
Получилась двухуровневая система:
Телефоны
    ↓
Synology Photos
    ↓
/photo/MobileBackup
    ↓
Python-скрипт
    ↓
Чистый семейный архив
Synology Photos принимает оригиналы с устройств.
А отдельный скрипт формирует из них уже организованную библиотеку.
Это позволяет не привязывать структуру архива к конкретному приложению.
Структура семейного архива
Для каждого члена семьи я сделал отдельный каталог.
Упрощённо структура выглядит так:
Фото и видео/
├── user1/
│   ├── Фото/
│   └── Видео/
├── user2/
│   ├── Фото/
│   └── Видео/
├── child1/
│   ├── Фото/
│   └── Видео/
├── child2/
│   ├── Фото/
│   └── Видео/
└── Общее/
Внутри персонального архива структура максимально простая:
Фото/
├── 2024/
│   ├── 01/
│   ├── 02/
│   └── ...
├── 2025/
└── 2026/
То есть:
Фото/YYYY/MMАналогично для видео:
Видео/YYYY/MMНапример:
Фото и видео/
└── user1/
    └── Фото/
        └── 2026/
            └── 10/
Я сознательно решил не строить внутри основного архива огромную систему тематических папок:
Отпуск
Море
Новый год
День рождения
Казань
Школа
Дача
Для этого гораздо удобнее использовать альбомы в Synology Photos или другом каталогизаторе.
Файловая система отвечает только на два вопроса:
чья это фотография и когда она была сделана.
Единый формат имени файла
Второе решение — привести новые файлы к одному формату.
Я использую:
YYYY-MM-DD HH.MM.SS.jpgНапример:
2026-10-03 14.27.18.jpgВидео:
2026-10-03 14.28.03.mp4Если несколько файлов имеют одинаковую дату и время, добавляется индекс:
2026-10-03 14.27.18.jpg
2026-10-03 14.27.18_02.jpg
2026-10-03 14.27.18_03.jpg
Это гораздо удобнее названий, которые создают камеры и телефоны:
IMG_4817.jpg
DSC_0832.JPG
PXL_20261003_112311.jpg
Даже без специального приложения сразу видно, когда была сделана фотография.
Откуда брать настоящую дату фотографии
Для JPEG главным источником даты является EXIF.
В первую очередь меня интересует поле:
DateTimeOriginalИменно оно обычно содержит момент съёмки.
Это принципиально важно, потому что использовать дату изменения файла нельзя.
Например, фотография реально была сделана:
2004-06-05Но после многократных копирований между компьютерами и дисками её mtime вполне может показывать:
2011-12-30Для фотоархива такая дата практически бесполезна.
Поэтому одно из основных правил моей системы:
Дата файловой системы не должна автоматически считаться датой съёмки.
Если надёжной даты нет — лучше оставить файл для ручного разбора.
Автоматическая сортировка
Скрипт проходит каталоги Synology Photos, получает дату съёмки и формирует путь назначения.
Логика примерно такая:
year = capture_date.yearmonth = capture_date.monthdestination = ( archive / "Фото" / f"{year:04d}" / f"{month:02d}")Если фотография была снята 3 октября 2026 года:
2026-10-03 14:27:18она отправится в:
Фото/2026/10/и получит имя:
2026-10-03 14.27.18.jpgПри этом совершенно неважно, в какой папке исходный файл находился раньше.
Если фотография лежит в условной папке 2007, но EXIF говорит, что она снята в январе 2008 года, архиватор положит её в:
Фото/2008/01/Источником истины является метадата фотографии, а не название старого каталога.
Почему я использую SHA-256
При разборе старого архива быстро выяснилось, что одинаковые фотографии могут лежать сразу в нескольких местах.
Сравнивать только имена файлов бесполезно.
Например:
IMG_0001.jpgна двух устройствах вполне может означать две совершенно разные фотографии.
Поэтому дубли я определяю по содержимому файла с помощью SHA-256.
Упрощённая функция:
import hashlibdef sha256(path): h = hashlib.sha256() with open(path, "rb") as f: for chunk in iter( lambda: f.read(4 * 1024 * 1024), b"" ): h.update(chunk) return h.hexdigest()Если два файла имеют одинаковый SHA-256, можно считать, что их содержимое идентично.
Это позволяет совершенно независимо от:
имени файла
каталога
даты файла
понять, является ли найденный файл уже существующей копией.
Самое важное правило: сначала копирование, потом проверка, и только потом удаление
Особенно осторожно я подошёл к миграции старых фотографий.
Я не хотел использовать обычное:
mv old.jpg new.jpgдля сотен и тысяч семейных фотографий.
Поэтому алгоритм получился таким:
Исходный файл
      ↓
копирование в .partial
      ↓
SHA-256 исходника
      ↓
SHA-256 копии
      ↓
сравнение
      ↓
переименование .partial
      ↓
повторная проверка
      ↓
удаление старого файла
То есть фактически:
COPY
  ↓
VERIFY
  ↓
FINALIZE
  ↓
VERIFY
  ↓
DELETE SOURCE
Пример:
shutil.copy2(source, partial)if sha256(partial) != sha256(source): raise RuntimeError("SHA-256 не совпадает")os.replace(partial, destination)if sha256(destination) != sha256(source): raise RuntimeError("Ошибка контрольной проверки")source.unlink()Исходный файл удаляется только тогда, когда новая копия уже существует и подтверждена по хэшу.
Для обычных файлов это может показаться избыточным.
Для семейного архива за 20 лет — нет.
Dry-run перед любым массовым изменением
Ещё одно правило, которое я использую практически во всех своих скриптах:
По умолчанию скрипт ничего не изменяет.
Первый запуск — только анализ.
Например:
python3 migrate_photos.pyможет показать:
Файлов найдено:      896
С датой EXIF:        886
Новых для переноса:  885
Дублей в архиве:       1
Без EXIF:             10
Ошибок:                0
Но файлы остаются на месте.
Для реальной операции необходимо явно указать:
python3 migrate_photos.py --applyМне такой подход оказался гораздо спокойнее любых автоматических «умных» миграций.
Сначала я вижу, что именно собирается сделать программа.
И только потом разрешаю ей это сделать.
Практический пример: разбор фотографий 2005–2010 годов
Один из этапов очистки старого каталога — фотографии за 2005–2010 годы.
Получился следующий результат:
2005: всего 50
2006: всего 368
2007: всего 158
2008: всего 222
2009: всего 55
2010: всего 43
Всего:
896 файловИз них EXIF удалось получить у:
886Файлов, которых ещё не было в новом архиве:
885Нашёлся один точный дубль.
А фотографий без нормальной EXIF-даты оказалось всего:
10И вот здесь особенно хорошо становится видно преимущество автоматизации.
Вместо того чтобы вручную просматривать и раскладывать 896 фотографий, мне осталось разобраться всего с десятью.
Что происходит с фотографиями без EXIF
Я специально не стал автоматически «угадывать» даты.
Если у фотографии нет надёжной даты EXIF, она остаётся там, где была.
Например:
Общее/
└── Фото/
    └── Фотографии/
        └── 2006/
            └── Старый каталог/
                └── photo.jpg
После автоматического переноса всех определившихся фотографий photo.jpg останется именно там.
Это оказалось очень удобно.
Папки постепенно очищаются, и в итоге на экране остаются только файлы, которые требуют человеческого решения.
Иногда точную дату всё-таки можно восстановить
Хороший пример — фотографии из поездки в Оптину пустынь.
Большая часть снимков имела EXIF с одной датой:
2004-06-05Но несколько десятков файлов выглядели так:
000012.jpg
000013.jpg
000016.jpg
000028.jpg
000029.jpg
и вообще не содержали EXIF-даты.
При этом из контекста старого архива удалось достоверно установить, что они были сделаны в ту же поездку — 5 июня 2004 года.
Всего таких фотографий оказалось 32.
Я решил не придумывать несуществующее время:
00:00:00а оставить известную часть даты и исходный номер:
2004-06-05 000012.jpg
2004-06-05 000013.jpg
2004-06-05 000016.jpg
Файлы отправились в:
Фото/2004/06/Это важный принцип всей системы:
Лучше сохранить неполную, но достоверную информацию, чем добавить красивую, но выдуманную.
Пустые каталоги удаляются автоматически
После переноса фотографий скрипт идёт по старым папкам снизу вверх.
Например:
2007/
└── 05/
    └── Праздник/
Если после миграции внутри ничего не осталось, сначала удалится:
Праздникзатем:
05а если пустым окажется весь год — и:
2007В Python это можно сделать через:
for current, dirs, files in os.walk( root, topdown=False): try: Path(current).rmdir() except OSError: passrmdir() здесь удобен именно своей безопасностью.
Он удалит только полностью пустой каталог.
Если внутри осталось хотя бы одно неразобранное фото — директория сохранится.
Что делать со скриншотами
После нескольких лет использования смартфонов становится понятно, что скриншоты — отдельный вид информации.
Среди них могут быть:
переписки
товары
QR-коды
карты
чеки
ошибки программ
мемы
временные заметки
Я не хочу смешивать их с обычными семейными фотографиями.
При этом удалять их из Synology Photos автоматически тоже не хочется.
Поэтому скриншоты обрабатываются отдельно и не попадают в основной чистый фотоархив.
Получается:
Synology Photos
├── фотографии
└── скриншоты
а в curated-архив:
Фото/YYYY/MMидут только нормальные фотографии.
Отдельная проблема — Live Photo с iPhone
Live Photo технически часто представляет собой пару файлов:
IMG_1234.HEIC
IMG_1234.MOV
Если просто архивировать все .MOV, каталог видео быстро наполняется огромным количеством коротких роликов.
Поэтому для Live Photo я использую отдельную проверку.
Компонент .MOV, относящийся к Live Photo, остаётся в Synology Photos, но не рассматривается как самостоятельное семейное видео.
Иначе через несколько лет папка:
Видеопревратится в свалку нескольких тысяч двух- и трёхсекундных клипов.
Список файлов, которые нужно игнорировать
Во время очистки выяснилось ещё одно.
Иногда файл хочется оставить в исходном Synology Photos, но больше никогда не переносить в основной архив.
Для этого я сделал простой:
ignore.txtВ нём находятся полные пути:
/photo/MobileBackup/user/device/DCIM/Camera/video1.mp4
/photo/MobileBackup/user/device/DCIM/Camera/video2.mp4
Архиватор читает этот файл и просто пропускает указанные объекты.
Это оказалось гораздо удобнее, чем создавать отдельные каталоги Rejected, Saved и тому подобное.
Зачем здесь SQLite
Постоянно сканировать десятки тысяч файлов с вычислением хэшей было бы не очень разумно.
Поэтому основной архиватор ведёт небольшую SQLite-базу.
В ней сохраняется состояние уже обработанных файлов.
Упрощённая идея:
исходный путь
размер
состояние обработки
путь назначения
контрольные данные
При следующем запуске скрипту не приходится заново делать всю работу.
Он концентрируется на новых файлах, появившихся после последней обработки.
Таким образом ежедневная автоматизация остаётся достаточно быстрой даже при большой библиотеке.
Автоматический запуск через DSM Task Scheduler
После того как логика была проверена вручную, скрипты можно запускать через планировщик Synology DSM.
Например, общий wrapper может выглядеть примерно так:
#!/bin/sh

PYTHON=/bin/python3
BASE="/volume1/drive/Temp/.photo-archive"

$PYTHON "$BASE/screenshots.py" --apply || exit 1

$PYTHON "$BASE/photo_to_archive.py" --apply || exit 1
Здесь есть ещё одна важная деталь:
|| exit 1Если первый этап завершился с ошибкой, второй не запускается.
Когда работа идёт с единственным семейным фотоархивом, лучше остановить процесс при первой же неожиданности, чем пытаться во что бы то ни стало его закончить.
Папка «Общее» оказалась главным наследием старой системы
Самая большая проблема была даже не в новых фотографиях.
Новые файлы уже можно автоматически принимать по нормальным правилам.
Гораздо сложнее оказалось разобрать наследие предыдущих десятилетий.
У меня существовала большая папка:
ОбщееВ которой за годы накопились:
старые фотографии
поездки
отсканированные снимки
школьные фотографии
семейные события
видео
фотографии с разных фотоаппаратов
В какой-то момент в ней было более 12 тысяч фотографий.
Теперь я постепенно её разгружаю.
Если фотографию можно однозначно отнести к конкретному члену семьи:
Общее
   ↓
Персональный архив
Если фотография действительно общая или её принадлежность определить невозможно — она остаётся в Общее.
Почему я не хочу хранить всё только по событиям
На первый взгляд структура:
2026/
├── Казань
├── День рождения
├── Новый год
├── Дача
└── Море
кажется более удобной.
Проблема появляется через десять лет.
Одна и та же фотография может одновременно относиться к:
ребёнку
поездке
дню рождения
определённому городу
семейному событию
Физический файл при этом всё равно должен лежать только в одном месте.
Для смысловой классификации лучше использовать:
альбомы
метки
лица
географию
поиск
А файловой системе оставить простую и однозначную хронологию.
В результате у меня получилось три независимых уровня
Сейчас я рассматриваю систему так.
1. Synology Photos
Отвечает за:
загрузку с телефонов
просмотр
мобильный доступ
Live Photo
временное хранение оригиналов
2. Файловый архив
Отвечает за долгосрочное хранение:
Фото и видео/
├── user1/
├── user2/
├── child1/
├── child2/
└── Общее/
с понятной структурой:
Фото/YYYY/MM
Видео/YYYY/MM
3. Каталогизатор
Поверх этого можно использовать:
Synology Photos
Immich
другую DAM-систему
обычный файловый менеджер
Каталогизатор можно поменять.
Файловый архив при этом останется прежним.
Как выглядит вся схема целиком
В итоге архитектуру можно представить так:
┌──────────────────────┐
│      Смартфоны       │
└──────────┬───────────┘
           │
           ▼
┌──────────────────────┐
│   Synology Photos    │
│   Mobile Backup      │
└──────────┬───────────┘
           │
           ▼
┌──────────────────────┐
│ Исходные фотографии │
│   /photo/...         │
└──────────┬───────────┘
           │
           ▼
┌──────────────────────┐
│   Python-архиватор   │
├──────────────────────┤
│ EXIF                 │
│ MP4/MOV metadata     │
│ SHA-256              │
│ Live Photo           │
│ screenshots          │
│ ignore.txt           │
│ SQLite               │
└──────────┬───────────┘
           │
           ▼
┌──────────────────────┐
│   Чистый фотоархив   │
│                      │
│ Фото/YYYY/MM         │
│ Видео/YYYY/MM        │
└──────────────────────┘
Несколько правил, к которым я пришёл
После разбора старого архива у меня сформировалось несколько принципов:
- Не считать приложение фотоархивом. Архивом должны оставаться сами файлы.
- Не доверять
mtimeстарых файлов как дате съёмки. После копирования между дисками она практически ничего не означает. - Не удалять оригинал до проверки новой копии.
- Использовать SHA-256 для настоящей дедупликации.
- Перед массовыми изменениями всегда делать dry-run.
- Не придумывать дату, которой не знаешь.
- Автоматизировать очевидные 95–99%, а спорные фотографии оставлять человеку.
Последний пункт, наверное, оказался самым важным.
Цель автоматизации — не добиться любой ценой:
0 неопределённых файловЦель — превратить:
896 фотографий для ручного разборав:
10 фотографий для ручного разбораА с десятью уже можно спокойно разобраться самому.
Резервные копии всё равно обязательны
Вся описанная автоматизация решает вопрос организации, но не заменяет резервное копирование.
NAS сам по себе не является резервной копией, если фотография существует только на нём.
Перед массовой перестройкой старого архива я бы в любом случае рекомендовал иметь ещё хотя бы одну независимую копию данных.
Особенно перед операциями, которые включают удаление исходников.
Также на время действительно больших миграций полезно приостанавливать облачную синхронизацию, чтобы тысячи промежуточных перемещений не начали одновременно повторяться в облаке.
Итог
Раньше мой семейный архив представлял собой результат двадцати с лишним лет использования разных фотоаппаратов, телефонов, компьютеров и способов хранения.
Теперь его основная структура выглядит предельно просто:
Фото и видео/
├── Человек 1/
│   ├── Фото/YYYY/MM
│   └── Видео/YYYY/MM
├── Человек 2/
├── Ребёнок 1/
├── Ребёнок 2/
└── Общее/
Новые фотографии автоматически загружаются с телефонов в Synology Photos, после чего отдельный архиватор:
определяет дату
↓
проверяет EXIF
↓
находит дубли
↓
вычисляет SHA-256
↓
создаёт правильное имя
↓
раскладывает по годам и месяцам
А старый архив можно постепенно пропускать через ту же систему.
Автоматически разбирается всё, что можно определить достоверно.
На месте остаются только спорные фотографии.
Именно такой подход мне в итоге нравится больше всего: машина делает рутинную работу, но не начинает придумывать информацию там, где её на самом деле нет.
А главное — через много лет я всё равно смогу открыть каталог обычным файловым менеджером и понять, что в нём находится, даже если ни Synology Photos, ни сегодняшних программ уже не будет существовать.